DepWorldSG: Depth-Aware 3D Semantic Scene Graph Generation via World-Model Priors.- Low-latency Event-based Object Detection with Spatially-Sparse Linear Attention.- RAGrasp: A Retrieval-Augmented Framework with Diversity-Aware Modeling for Dexterous Grasp Generation.- CoCo: Code as CoT for Text-to-Image Preview and Rare Concept Generation.- PDF-Omni: Poincaré Dual Disk Distortion Field-based Recurrent Update for Omnidirectional Stereo Matching.- Don’t Mask Out the Background! Natural-Light Photometric Stereo via Illumination Reconstruction.- Reflection-Aware Reasoning for Non-Line-of-Sight Pedestrian Localization.- Online Segment 3D Gaussians via Launching Virtual Drones.- Perceptual Projection Pruning: Diversity-Aware Video Token Pruning for Multimodal Large Language Models.- AVTok: 1D Unified Tokenization for Holistic Audio-Video Generation.- ORFC: Orthogonal Reparameterization for Low-Bitrate ViT Feature Coding.- AnchorWeave: World-Consistent Video Generation with Retrieved Local Spatial Memories.- Proteus: Model Leakage-Induced Adversarial Attack in Federated Learning.- MemRoPE: Training-Free Infinite Video Generation via Evolving Memory Tokens.- ScanFocus: A Coarse-to-Fine Framework for Spatio-Temporal Video Grounding.- Predicting Consequences and Reinforcing Navigation Policies with Latent World Models.- Attention-based Vision-Language Memory for Spatial Reasoning.- Teaching Vision-Language-Action Models What to See and Where to Look.- ME-IQA: Memory-Enhanced Image Quality Assessment via Re-Ranking.- Learning 1-Bit LiDAR-based Localization with Auxiliary Objective.- Geo-ID: Test-Time Geometric Consensus for Cross-View Consistent Intrinsics.- UniH3: Unifying Hierarchical Homogeneity and Heterogeneity for All-in-One Medical Image Restoration.- Urban Boundaries, Social Barriers: A Benchmark and Vision-Centric Framework for Mapping Gated Communities and Equity Implications.- ORION: Ordinal Neural Collapse as a Representation Prior for Visual Navigation.- Personalized Reward Modeling for Text-to-Image Generation.- GCMRD: Global Consistency Multi-teacher Robustness Distillation.- Keep Your Friends Close, and the Right Neighbours Closer: Disaster-Conditioned Kernel-Regularized Graph Attention for Building Damage Classification.- TecoPrompt: Temporal-Conservative Prompt Learning for Vision-Language Models.- Diagram-MMU: A Multi-Modal Benchmark for Scientific Diagrams.- ViQ: Text-Aligned Visual Quantized Representations at Any Resolution.- GAP-MLLM: Geometry-Aligned Pre-training for Activating 3D Spatial Perception in Multimodal Large Language Models.- VVSim: A Large-Scale Aerial-Ground Dataset and Benchmark for Cooperative Perception.- Bayesian Self-Attention with Local Pixel Correlations for Lightweight Denoising Transformers.- NanoVSR: Towards Real-Time Video Super-Resolution on Edge Devices.- Debiased Textual Prompt Tuning for Enhancing Unknown Class Discovery.- Streaming Dense Voxel Representations for 3D Occupancy Prediction.- ReconDreamer-RL: Enhancing Reinforcement Learning via Diffusion-based Reconstruction.
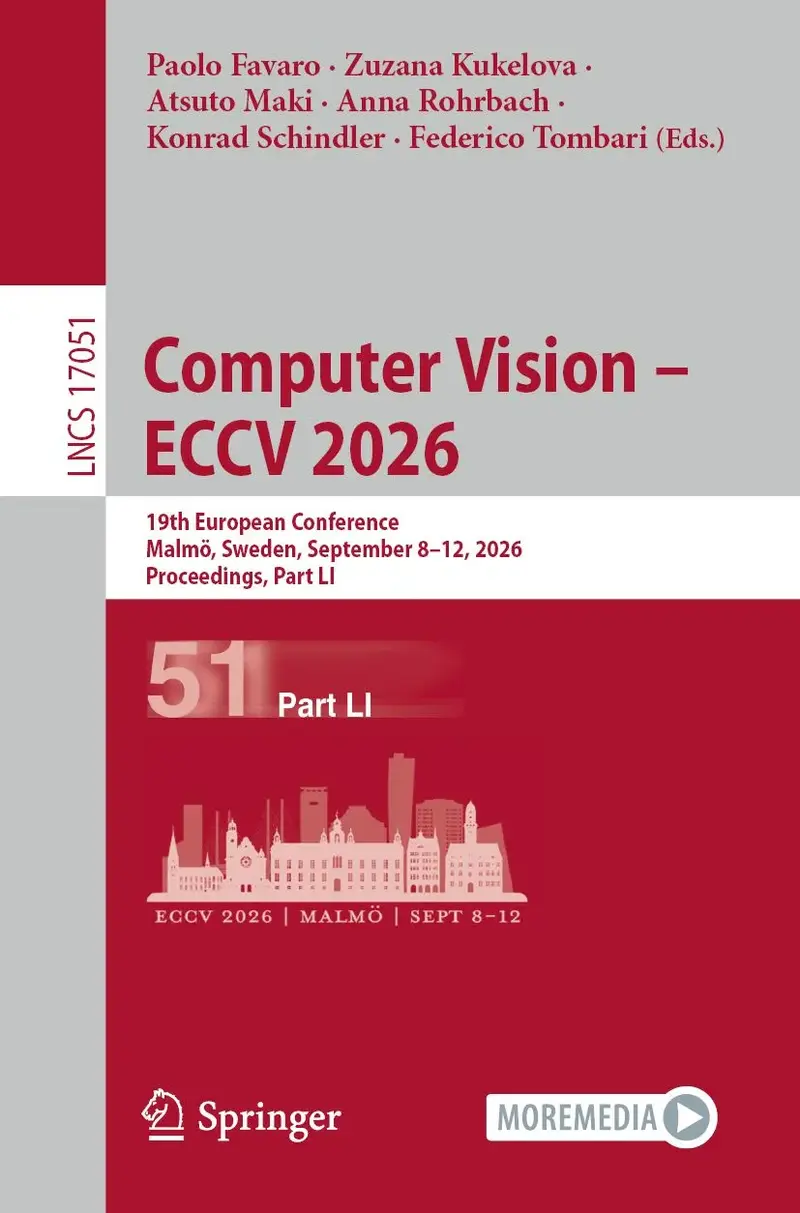
Computer Vision – ECCV 2026
Ursprünglicher Preis war: 96,29 €67,40 €Aktueller Preis ist: 67,40 €.
📍 -- Personen haben dieses Produkt kürzlich angesehen
🚚 Voraussichtliche Lieferung: Okt. 14 - Okt. 19
📦 Versandrichtlinie: Kostenloser Versand bei Bestellungen über 25 €
🛡️ 30-Tage-Rückgabe: Kostenlose Rücksendung, keine Wiederaufnahmegebühren
✉️ Kundensupport: 24/7 Unterstützung
🔒 Sicherer Checkout
Ähnliche Produkte
-
E-Book
Gemeinsam Versorgungsqualität stärken
Ursprünglicher Preis war: 39,99 €27,99 €Aktueller Preis ist: 27,99 €. In den Warenkorb -
E-Book
Handbook of Traditional Spirituality and Sustainability
Ursprünglicher Preis war: 213,99 €160,49 €Aktueller Preis ist: 160,49 €. In den Warenkorb -
E-Book
Das Gartenfest
Ursprünglicher Preis war: 16,99 €11,89 €Aktueller Preis ist: 11,89 €. In den Warenkorb -
E-Book
Robotics and Mechatronics
Ursprünglicher Preis war: 298,53 €223,90 €Aktueller Preis ist: 223,90 €. In den Warenkorb
Rezensionen
Es gibt noch keine Rezensionen.