RT-SDGOD: Real-Time Single-Domain Generalized Object Detection.- WildSplat: Feedforward Gaussian Splatting from Unposed In-the-Wild Images.- Nexus-Vid: Efficient Frequency Bridging with Homogeneous Latent Space for Video Unified Models.- Articulated Object Reconstruction from Rest-State Observation.- Memory-V2V: Memory-Augmented Video-to-Video Diffusion for Consistent Multi-Turn Editing.- RefReward-SR: LR-Conditioned Reward Modeling for Preference-Aligned Super-Resolution.- OpenSubject: Leveraging Video-Derived Identity and Diversity Priors for Subject-driven Image Generation and Manipulation.- Achieving Subcategorical Erasure in Text-to-Image Models.- SE-DETR: Explicit Semantic Exploration for Generalizability and Distinguishability in Video Temporal Grounding.- C3ASD: Multi-Level Consistency-Driven Representation Learning for Robust Active Speaker Detection.- URoPE: Universal Relative Position Embedding across Geometric Spaces.- Triangle Splatting SLAM.- Learning to Generate Rigid Body Interactions with Video Diffusion Models.- RSICCLLM: A Multimodal Large Language Model for Remote Sensing Image Change Captioning.- Art Beyond Semantics: Sheaf-Informed Contrastive Learning for Multi-Relational Representations.- StereoEdit: A Diffusion-Based Framework for Stereo-Consistent Image Editing.- ELT: Elastic Looped Transformers for Visual Generation.- InstaPano: Zero-shot Instance Layout Controlled Panorama Generation Via Global Attention Fusion.- JoVA: Unified Multimodal Learning for Joint Video-Audio Generation and Editing.- IRIS: A Real-World Benchmark for Inverse Recovery and Identification of Physical Dynamic Systems from Monocular Video.- Eliciting Self-Verification in Multimodal Reasoning Agents with Reinforcement Learning.- SplatPainter: Interactive Authoring of 3D Gaussians from 2D Edits via Test-Time Training.- MV2GF: Multi-view Pedestrian Detection with a Visual Geometric Foundation Model.- Generalized Biomedicine Discovery.- Frames2Residual: Spatiotemporal Decoupling for Self-Supervised Video Denoising.- FlowPainter: Inpainting Optical Flow via Confidence-Guided Completion.- StyleFusion360: View-Consistent Head Stylization via Adaptive Style Modulation.- Segmenting, Fast and Slow: Real-Time Open-Vocabulary Video Instance Segmentation with Dual-Path Processing.- Towards Reliable Multi-Label Classification via Conditional Dependency Modeling.- Denoising the Deep Sky: Physics-Based CCD Noise Formation for Astronomical Imaging.- MGM-Omni: Scaling Omni LLMs to Personalized Long-Horizon Speech.- Image Warping for Image-to-Image Translation.- InstaEdit: Instant Image Editing via Optimized Noise Prediction.- Anchoring and Steering Diffusion: Enhancing the Faithfulness of Text-to-Image Generation at Inference Time.- RefAlign: Representation Alignment for Reference-to-Video Generation.- Obliviate: Erasing Concepts from Autoregressive Image Generation Models.- GenHOI: Generalized Hand-Object Pose Estimation with Occlusion Awareness.
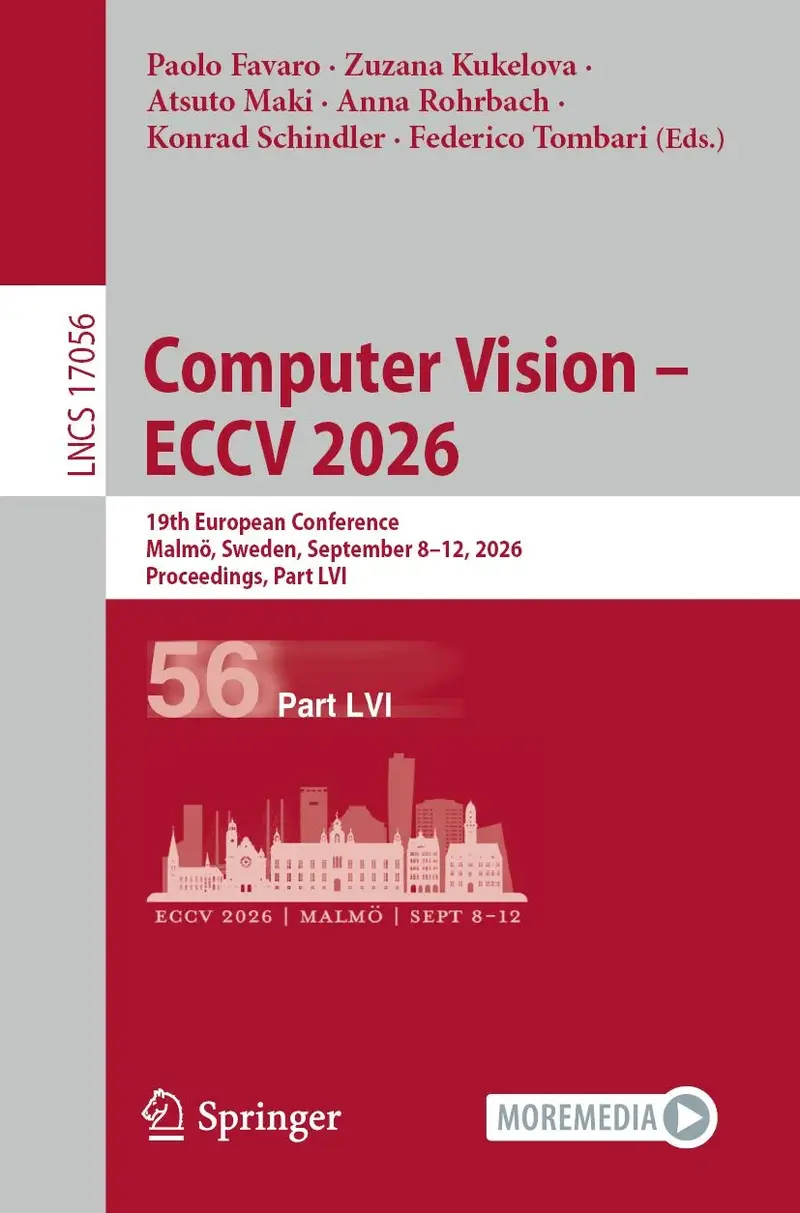
Computer Vision – ECCV 2026
Ursprünglicher Preis war: 96,29 €67,40 €Aktueller Preis ist: 67,40 €.
📍 -- Personen haben dieses Produkt kürzlich angesehen
🚚 Voraussichtliche Lieferung: Okt. 14 - Okt. 19
📦 Versandrichtlinie: Kostenloser Versand bei Bestellungen über 25 €
🛡️ 30-Tage-Rückgabe: Kostenlose Rücksendung, keine Wiederaufnahmegebühren
✉️ Kundensupport: 24/7 Unterstützung
🔒 Sicherer Checkout
Ähnliche Produkte
-
E-Book
Robotics and Mechatronics
Ursprünglicher Preis war: 298,53 €223,90 €Aktueller Preis ist: 223,90 €. In den Warenkorb -
E-Book
Der Himmel über Carrara
Ursprünglicher Preis war: 14,99 €10,49 €Aktueller Preis ist: 10,49 €. In den Warenkorb -
E-Book
Amerika ’33
Ursprünglicher Preis war: 22,99 €16,09 €Aktueller Preis ist: 16,09 €. In den Warenkorb -
E-Book
A Century of Cosmic Discoveries
Ursprünglicher Preis war: 117,69 €88,27 €Aktueller Preis ist: 88,27 €. In den Warenkorb
Rezensionen
Es gibt noch keine Rezensionen.