Axolotl3D: a Unified Framework for Faithful 3D Shape Completion.- Geometrically Consistent Multi-View Scene Generation from Freehand Sketches.- Gradient sparsity regularization for training unlearning-compatible models.- Iterative Perceptual Alignment for VLMs via Deterministic Reconstruction Feedback.- SeeClear: Reliable Transparent Object Depth Estimation via Generative Opacification.- Training-Free Multi-Concept Image Editing.- OVGGT: O(1) Constant-Cost Streaming Visual Geometry Transformer.- Stream3D-VLM: Online 3D Spatial Understanding with Incremental Geometry Priors.- NumColor: Precise Numeric Color Control in Text-to-Image Generation.- PRISM3D: Probabilistic Refinement and Robust Initialization for Physically Consistent Scene Modeling under Extreme Motion Blur.- Linguistically-Aligned and Visually-Grounded Preference Optimization for Clinically-Augmented Medical Report Generation.- Neural Gate: Mitigating Privacy Risks in LVLMs via Neuron-Level Gradient Gating.- OmniCoT: A Benchmark for Global and Multi-Step Panoramic Reasoning.- Contextual Image Attack: How Visual Context Exposes Multimodal Safety Vulnerabilities.- CtrlCoMo: Controllable Co-Speech Motion Generation with Gesture–Action Disentanglement.- CARA: Collision-Aware Resolution Adaptation for Multiresolution Hash Encoding Based Image Fitting.- What Moves? Localized Motion Representations for Compositional Scene Control.- Liquid Fusion of Heterogeneous Representations Towards General Salient Object Detection.- Gravity-aware partially calibrated absolute pose estimation from affine- or rotation-covariant features.- LASER: A Corrective Lens for LVLMs via Visual Attention Preservation and Sink Suppression.- Learning Consistent Temporal Grounding between Related Tasks in Sports Coaching.- One-Shot Feed-Forward 360° Animatable Avatar via Inpainted UV-Space Gaussian Modeling.- HuCollisionField: Resolving Self-Collisions via Neural Fields for Human Prediction.- ReliefSAM: A Geometry-Augmented Multi-Prior Adapter for Bas-Relief Segmentation.- Breaking the Model Forgetting Cycle in Long-Incremental 3D Object Detection.- URHead: A Unified UV-Space Representation for Joint Mesh–3DGS Optimization in Head Avatars.- Let’s Reward Step-by-Step: Step-Aware Contrastive Alignment for Vision-Language Navigation in Continuous Environments.- Audio-Visual Continual Test-Time Adaptation without Forgetting.- λSplit: Self-Supervised Content-Aware Spectral Unmixing for Fluorescence Microscopy.- Denoising-GS: Gaussian Splatting with Spatial-aware Denoising.- Fully Rotation-Equivariant Spectral-Spatial Learning for Multispectral Object Detection.- CURE: Contextual Debiasing and Unbiased Refinement for Training-Free Open-Vocabulary Semantic Segmentation.- AnchorPrune: Relevance-Anchored Contextual Expansion for Visual Token Pruning.- MoGAN: Improving Motion Quality in Video Diffusion via Few-Step Motion Adversarial Post-Training.- FSDC-DETR: A Frequency-Spatial Domain Collaborative DETR for Small-Object Detection.- Accurate Zero-shot Quantization via Hierarchical Teacher-Assistant Distillation.- LightSTAR: Efficient Visual Document Retrieval via Lightweight Selection with Vision-Adaptive Refinement.
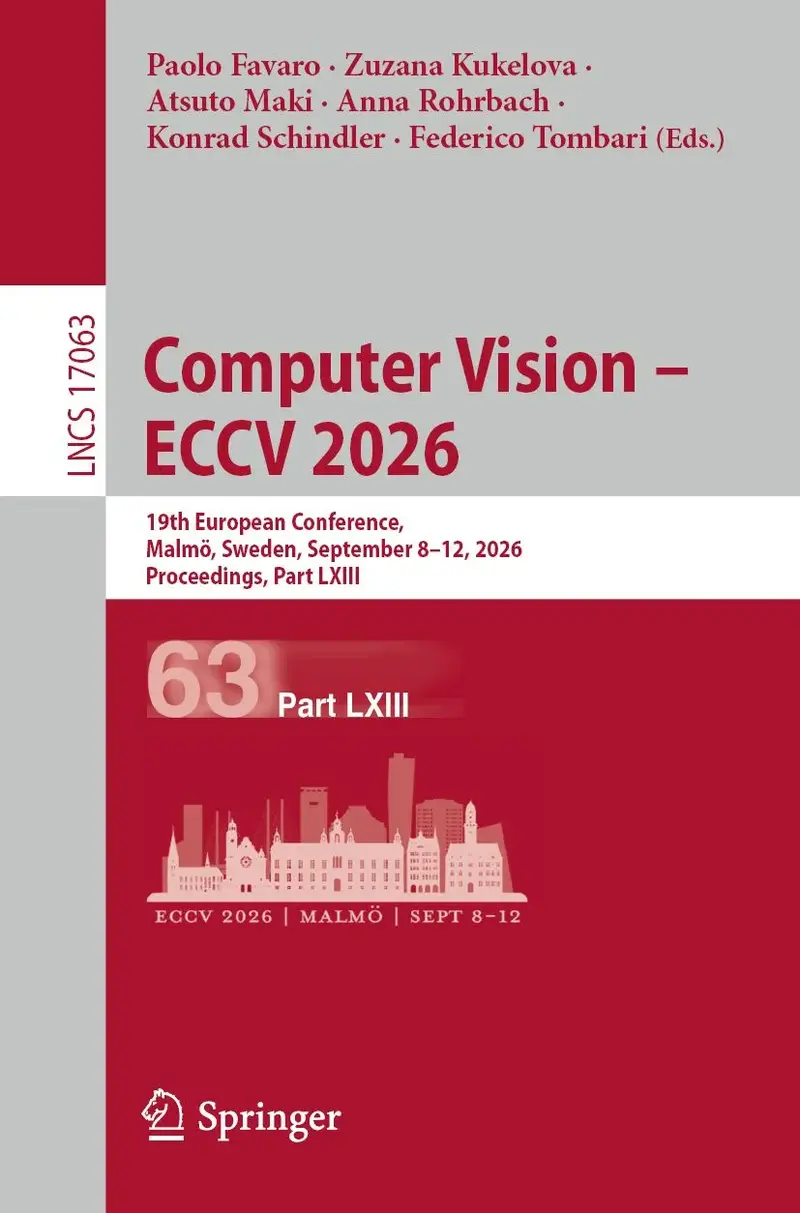
Computer Vision – ECCV 2026
Ursprünglicher Preis war: 96,29 €67,40 €Aktueller Preis ist: 67,40 €.
📍 -- Personen haben dieses Produkt kürzlich angesehen
🚚 Voraussichtliche Lieferung: Okt. 14 - Okt. 19
📦 Versandrichtlinie: Kostenloser Versand bei Bestellungen über 25 €
🛡️ 30-Tage-Rückgabe: Kostenlose Rücksendung, keine Wiederaufnahmegebühren
✉️ Kundensupport: 24/7 Unterstützung
🔒 Sicherer Checkout
Ähnliche Produkte
-
E-Book
Computational Science and Its Applications – ICCSA 2026 Workshops
Ursprünglicher Preis war: 53,49 €37,44 €Aktueller Preis ist: 37,44 €. In den Warenkorb -
E-Book
Gemeinsam Versorgungsqualität stärken
Ursprünglicher Preis war: 39,99 €27,99 €Aktueller Preis ist: 27,99 €. In den Warenkorb -
E-Book
Obstetrics
Ursprünglicher Preis war: 748,99 €300,00 €Aktueller Preis ist: 300,00 €. In den Warenkorb -
E-Book
Analysis of Sinter-Based Additive Manufacturing for Functional Products
Ursprünglicher Preis war: 119,99 €89,99 €Aktueller Preis ist: 89,99 €. In den Warenkorb
Rezensionen
Es gibt noch keine Rezensionen.